智能报表的原理是什么?它是如何运行的
智能报表原理揭秘:从数据接入、清洗、建模到AI自动洞察,四步流水线如何减少人工干预,实现实时分析与预警。了解其运行机制、核心优势与局限,助你选对工具,提升决策效率。
智能报表原理揭秘:从数据接入、清洗、建模到AI自动洞察,四步流水线如何减少人工干预,实现实时分析与预警。了解其运行机制、核心优势与局限,助你选对工具,提升决策效率。
你花在整理报表上的时间,有多少真正花在看数据上?这个问题,我问过不少做运营和管理的朋友。答案往往很扎心——大部分时间都耗在导数据、清洗数据、调格式、对口径上,真正留给“看数据、想问题、做决策”的时间,少得可怜。
传统报表就是这样,靠人拉数、人做表、人找问题。而智能报表的逻辑完全不同,它把“人找问题”变成了“系统自动给结果”。那智能报表的原理到底是什么?它又是怎么一步步跑起来的?这篇文章,我就把这条流水线拆开给你看。
先看一张对比表,你就明白两者的核心差异在哪:
| 对比维度 | 传统报表 | 智能报表 |
|---|---|---|
| 取数方式 | 人工写SQL或手动导出 | 系统自动连接多源数据 |
| 数据更新 | 定期手动刷新 | 实时或定时自动同步 |
| 报表格式 | 固定模板,改需求要重新做 | 动态生成,按需调整 |
| 分析方式 | 被动查询,用户自己找问题 | 主动洞察,自动发现异常 |
| 使用门槛 | 需要懂技术或依赖IT部门 | 业务人员可自助操作 |
看到区别了吗?“智能”不是指图表做得好看,而是指数据从接入到洞察的整个链路中,人工干预大幅减少。传统报表是“人围着数据转”,智能报表是“数据围着人转”。它把人力从“做报表”这件事里解放出来,让你把精力放到“用报表”上——这才是它真正的价值。
要理解智能报表怎么工作,先得知道它背后有哪些模块在支撑。你可以把它想象成一个分工明确的厨房团队:
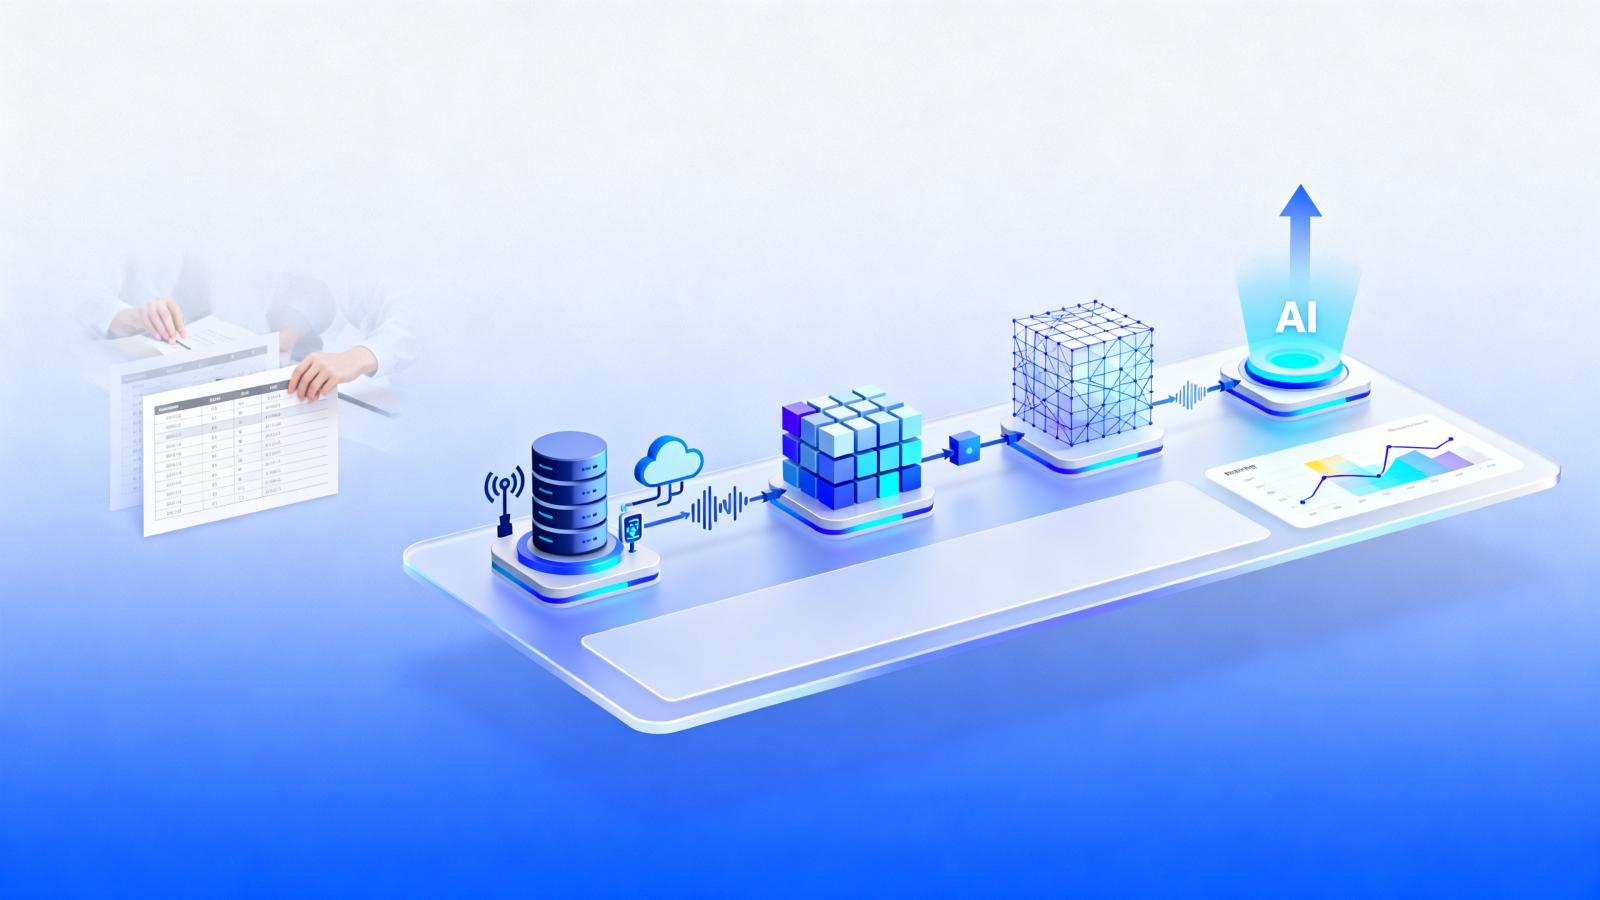
这些模块不是孤立存在的,而是串成一条完整的流水线。数据从进来到最终呈现,每一步都有明确分工,环环相扣。下面我就按这条流水线的四个关键环节,逐个拆解智能报表的运行机制。
智能报表的数据来源,远比你想象的要丰富。除了最常见的Excel表格,还包括:
关键点是,智能报表的“连接”不等于“拷贝”。它不是把数据复制一份放过来就完事,而是建立实时或定时的同步机制,保证你看到的数据是新鲜的。比如销售数据,系统可以每隔五分钟自动同步一次,而不是等你手动刷新。
以低代码平台为例,通过配置化方式就能对接多个业务系统,完全不需要写代码。你只需要在界面上选择数据源、配置同步频率,系统就会自动完成后续工作。
数据接进来了,但能用吗?不一定。原始数据里往往藏着各种问题:重复记录、空值、格式不统一、异常数据……如果直接拿这些数据做分析,结果肯定不靠谱。
这就是数据清洗要解决的问题。智能报表会自动完成以下几件事:
这一步是整个智能报表运行机制的地基。数据清洗做得不到位,后面所有分析都是空中楼阁。所以,别小看这个“不起眼”的环节,它直接决定了你的报表靠不靠谱。
清洗干净的数据还是散的,需要建立关联关系才能用起来。数据建模就好比给数据搭骨架——定义清楚表与表之间的关系。
举个例子:订单表里有客户ID,客户表里也有客户ID。智能报表要能自动识别出这两个字段的关联关系,然后告诉你:“这两张表可以通过客户ID关联起来。”这样你就能同时从订单表和客户表里取数据做分析了。
在具体操作上,智能报表通常提供两种建模方式:一是自动识别,系统根据字段名称和数据特征自动匹配关联关系;二是手动配置,通过拖拽方式让用户自己定义关系。
这里还要提两个核心概念:指标和维度。
理解了这两个概念,你就能明白智能报表如何组织数据了。
传统报表里,你要算个同比环比,得自己写公式或者让IT帮忙。智能报表则完全不同——你只需要选择指标和维度,系统自动完成所有计算。
举个例子:你想看“按月份各区域的销售额”,只需要在界面上把“销售额”拖到指标区,把“月份”和“区域”拖到维度区,系统就会自动聚合数据,生成结果表。不需要写SQL,不需要记公式,所有计算在后台自动完成。
这就是智能报表如何工作的核心逻辑之一:把复杂的计算过程封装起来,用户只需要关心“看什么”,不需要关心“怎么算”。
数据算出来了,怎么呈现最直观?智能报表会根据数据特征自动推荐合适的图表类型。比如:
这个“自动推荐”的逻辑并不神秘,本质上是系统根据数据的维度和指标特征,匹配最合适的可视化表达方式。当然,“自动生成”不等于“不能干预”,你完全可以手动切换图表类型,系统会记住你的偏好,下次优先推荐你常用的类型。
静态报表最大的问题是什么?你看到一个异常数据,想深挖原因,却没办法往下看。智能报表的交互功能彻底解决了这个问题。
想象这个场景:你在全国销售看板上看到华东区业绩突出,想看看具体是哪个省贡献的。点击“华东区”,系统自动下钻到各省数据;再点击“浙江”,继续下钻到具体门店。整个过程只需要点几下鼠标,数据层层展开,就像剥洋葱一样。
这种下钻、筛选、联动的交互方式,让报表从“静态报告”变成了“动态分析工具”。你不再被动接受固定的报表内容,而是可以主动探索数据、发现问题。
这是智能报表“智能”二字含金量最高的环节。系统通过算法持续监控数据,一旦发现异常,主动推送预警通知——不需要你天天盯着看板。
举个例子:某商品销量连续三天低于设定阈值,系统自动标记这条数据,并推送预警消息给运营人员。你还没发现问题,系统已经先一步“报警”了。
这种异常检测机制,背后是统计学方法和机器学习模型的结合。系统先学习数据的正常波动范围,然后识别偏离正常范围的异常点。对于企业运营来说,这意味着你不再需要每天人工翻报表找问题,系统帮你盯着。
你有没有遇到过这种情况:想看个数据,但不知道在报表里怎么操作?智能报表的自然语言查询功能,就是解决这个问题的。
你只需要在输入框里打字:“上个月哪个产品卖得最好?”系统会自动识别你的意图,转换成数据库查询语句,然后返回结果。这就是NL2SQL技术——把自然语言转换成SQL查询。
更进一步,AI还能生成简单的文字解读。比如系统不仅告诉你“A产品销量最高”,还会补充一句“A产品销量环比增长15%,主要增长区域在华南”。这种解读帮助用户快速理解“数据说明了什么”,而不是只看到一堆数字。
聊了这么多智能报表的运行机制,我也想客观泼点冷水。智能报表确实强大,但它有明确的边界:
用一句话总结:它帮你省掉80%的“做报表”时间,但剩下20%的“用报表”智慧,还得靠你自己。智能报表是提效工具,不是决策替身。
理解了智能报表的原理,选型时你就有了判断标准。我建议从四个维度评估:
另外,别忽略“落地成本”。实施周期多长?业务人员培训难度大不大?跟现有系统兼容性如何?这些都是实际使用中会遇到的坑。
像正远低代码平台这类工具,就是把上述原理封装成可视化的配置界面,让企业不用从零搭建这套体系。
智能报表的原理并不神秘,归根结底就是一条流水线:数据清洗→建模分析→可视化呈现→AI洞察预警。每一步都有成熟的技术支撑,每一步都在减少人工干预。
理解了这条流水线,你就能判断一个工具是“真智能”还是“假噱头”。下次选型或优化报表体系时,不妨按这四个环节逐一评估现有工具,找到真正能提升效率的环节。
数据报表不是目的,用数据做出更好的决策才是。做有效果的营销,做有利润的企业——这句话放在报表这件事上同样成立。